Googles Gemini-Batch-Inferenz bietet gegenüber Echtzeit-Inferenz einen Preisnachlass von 50 Prozent; bei Gemini-3-Modellen lassen sich Cache- und Batch-Rabatte kombinieren, sodass zwischengespeicherte Eingabe-Token insgesamt 95 Prozent günstiger werden als Standard-Token. Für Unternehmen, die große Mengen an Prompts asynchron verarbeiten, etwa zur Datenkategorisierung, Inhaltsproduktion oder Dokumentenanalyse, senkt die Batch-Inferenz die KI-Betriebskosten erheblich. Da keine sofortige Antwort erforderlich ist, lassen sich Hunderttausende Anfragen in einem einzigen Batch-Job bündeln. Der Dienst übernimmt Formatvalidierung, parallele Verarbeitung und automatische Wiederholungen mit dem Ziel, Aufträge binnen 24 Stunden abzuschließen.
Gemini Batch Inference: 50 Prozent Rabatt auf asynchrone KI-Verarbeitung für Unternehmen
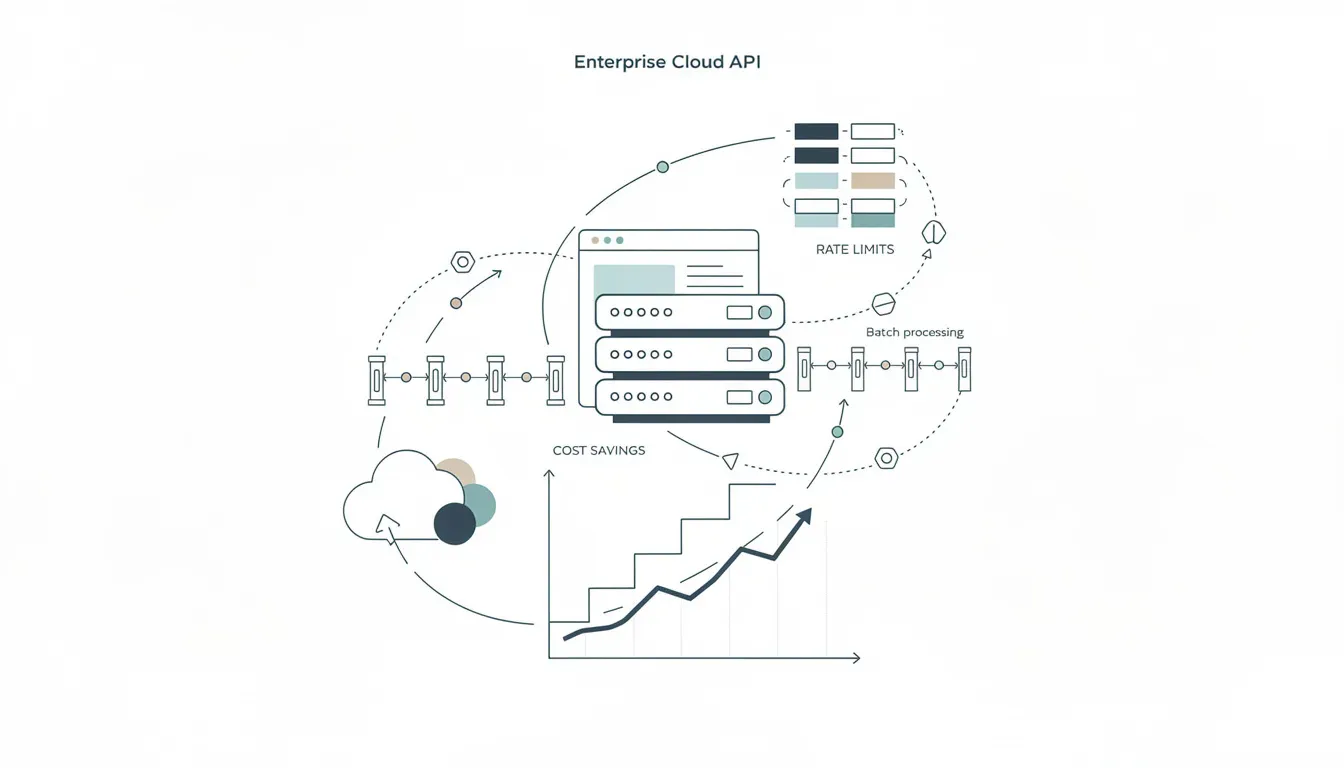
Google bietet über Vertex AI eine Batch-Inference-Funktion für Gemini-Modelle an, die asynchrone Massenverarbeitung zu einem Preisnachlass von 50 Prozent gegenüber Echtzeit-Inferenz ermöglicht. Für Gemini 3 und spätere Modelle lassen sich der Batch-Rabatt und der Rabatt auf gecachte Tokens kombinieren, was laut Google-Dokumentation zu einem Gesamtnachlass von 95 Prozent auf gecachte Eingabe-Tokens im Vergleich zu Standard-Inputpreisen führt.
Was Batch Inference leistet
Die Funktion war bislang unter dem Namen “Batch Prediction” bekannt und richtet sich an Anwendungsfälle, bei denen keine Antwort in Echtzeit erforderlich ist. Unternehmen können damit große Datensätze aus Prompts gebündelt verarbeiten, ohne Anfragen einzeln durch die Produktions-API zu schleusen. Google gibt an, dass ein einzelner Batch-Job Hunderttausende von Anfragen mit höheren Rate-Limits abwickeln kann als die synchrone Gemini-API.
Die Plattform übernimmt dabei automatisch Formatvalidierung, parallele Verarbeitung und Wiederholungsversuche bei Fehlern. Als Zielgröße für die Fertigstellung nennt Google 24 Stunden.
Praktische Implikationen für Entscheider
Kostenstruktur bei Gemini 2.5 und Gemini 3: Für Gemini-2.5-Modelle gilt: Der Batch-Rabatt von 50 Prozent und der Caching-Rabatt von 90 Prozent lassen sich nicht stapeln; der höhere Caching-Rabatt hat Vorrang. Bei Gemini 3 und neueren unterstützten Modellen hingegen können beide Rabatte kombiniert werden, was zu einem Gesamtnachlass von 95 Prozent auf gecachte Eingabe-Tokens führt. Wer die Modellgeneration bei der Architekturentscheidung berücksichtigt, kann erhebliche Betriebskostenunterschiede erzielen.
Typische Einsatzfelder laut Google-Dokumentation: Batch Inference eignet sich für Inhaltsproduktion in großem Maßstab (zum Beispiel Produktbeschreibungen oder Social-Media-Texte), Datenkategorisierung und Sentiment-Analyse, Offline-Zusammenfassungen und Dokumentenübersetzung sowie die Generierung von Vektorembeddings für semantische Suche. Für Embedding-Modelle gelten separate Limits: Das Modell gemini-embedding-001 unterstützt bis zu einer Million Zeilen pro Batch-Job und bis zu 10.000 parallele Jobs pro Projekt.
Workflow-Vereinfachung als Argument neben dem Preis: Statt komplexe Pipelines aus Einzelanfragen zu verwalten, reicht laut Dokumentation das Einreichen eines Batch-Jobs und das spätere Abrufen der Ergebnisse. Das reduziert den Entwicklungsaufwand für Teams, die wiederkehrende Analyseprozesse automatisieren wollen.
Implicit Caching standardmäßig aktiv: Für Gemini 2.5 und alle neueren Modelle ist das implizite Caching ohne zusätzliche Konfiguration aktiviert. Anfragen, deren Eingabe-Tokens bereits gecacht sind, profitieren automatisch vom entsprechenden Rabatt. Das kann insbesondere bei Workloads mit sich wiederholenden Kontextanteilen relevant sein, etwa bei der Verarbeitung gleichartiger Dokumentstrukturen.
Für einen direkten Vergleich der Gemini-Preisstruktur mit anderen API-Anbietern lohnt sich ein Blick auf die Gemini 2.0 Flash API: Kosten, Token-Limits und Kontextfenster im Vergleich. Wie sich Google Cloud Vertex AI in Enterprise-Architekturen einbettet, beleuchtet der Artikel zu Vertex AI 2025: Enterprise-Integration und Pricing. Wer Batch-Verarbeitung auch bei anderen Anbietern evaluiert, findet einen Überblick im Artikel zur Anthropic Claude Batch API: Asynchrone Verarbeitung und Kostenoptimierung.
Quellen
- Batch inference with Gemini (Google Cloud, englisch)
- Inférence par lot avec Gemini (Google Cloud, französisch)
- 使用 Gemini 进行批量推理 (Google Cloud, chinesisch)
Häufige Fragen
Was ist der Unterschied zwischen Batch-Inferenz und Echtzeit-Inferenz bei Gemini?
Bei der Echtzeit-Inferenz erhalten Sie sofortige Antworten auf einzelne Anfragen, was für interaktive Anwendungen notwendig ist. Die Batch-Inferenz hingegen verarbeitet große Datensätze asynchron und mit höherem Durchsatz. Sie übermitteln einen Batch-Job und rufen die Ergebnisse nach Abschluss ab. Der Dienst übernimmt dabei Formatvalidierung, parallele Verarbeitung und automatische Wiederholungsversuche, mit dem Ziel, die Verarbeitung innerhalb von 24 Stunden abzuschließen.
Wie hoch sind die Kosteneinsparungen bei der Gemini Batch-Inferenz?
Laut Google Cloud-Dokumentation kostet die Batch-Verarbeitung 50 % weniger als die Echtzeit-Inferenz. Für Gemini 2.5 und neuere Modelle ist implizites Caching standardmäßig aktiviert, das einen Rabatt von 90 % auf gecachte Eingabe-Tokens bietet. Bei Gemini 3 und neueren Modellen lassen sich Batch- und Cache-Rabatt kombinieren, was einen Gesamtrabatt von 95 % auf gecachte Eingabe-Tokens ermöglicht. Bei Gemini 2.5 gelten die Rabatte hingegen nicht kumulativ.
Für welche Unternehmensanwendungen eignet sich die Gemini Batch-Inferenz besonders?
Google nennt konkret folgende Anwendungsfälle: Massenhafte Inhaltsgenerierung wie Produktbeschreibungen oder Social-Media-Texte, Datenannotation und -klassifikation wie Sentimentanalyse oder Dokumentenkategorisierung, Offline-Analysen wie Artikelzusammenfassungen oder Dokumentenübersetzungen sowie die Generierung von Vektoreinbettungen für semantische Suche, Retrieval und Clustering. Gemeinsam ist diesen Szenarien, dass keine sofortige Antwort erforderlich ist.
Welche Rate-Limit-Vorteile bietet die Batch-Inferenz gegenüber der Gemini Echtzeit-API?
Die Batch-Inferenz erlaubt es, Hunderttausende von Anfragen in einem einzigen Batch-Job mit höheren Rate Limits zu verarbeiten, als sie die Echtzeit-Gemini-API bietet. Für Embedding-Modelle wie gemini-embedding-001 unterstützt ein einzelner Batch-Job bis zu 1.000.000 Zeilen, und pro Projekt können bis zu 10.000 parallele Batch-Jobs in der Warteschlange gehalten werden. Die für Echtzeit-Anfragen geltenden Anfrage-Limits gelten für Embedding-Batch-Jobs nicht.
Welche Gemini-Modelle unterstützen die Batch-Inferenz, und gilt das auch für Embedding-Modelle?
Laut Google Cloud-Dokumentation unterstützen sowohl Basis-Gemini-Modelle als auch feinabgestimmte Gemini-Modelle die Batch-Inferenz. Zusätzlich ist Batch-Inferenz für Embedding-Modelle verfügbar, darunter die Gemini-Embedding-Modelle gemini-embedding-001 und gemini-embedding-2 (Vorschau) sowie ältere Modelle wie text-embedding-004, text-embedding-005 und text-multilingual-embedding-002 mit bis zu 30.000 Prompts je Anfrage.
Dieser Artikel wurde von einem KI-System automatisiert erstellt. Kennzeichnung gemäß Art. 50 der EU-KI-Verordnung.